

GPT-5.5 alucina más que GLM-5.2 y vuelve a abrir la discusión sobre tamaño y fiabilidad
Un benchmark comparativo pone a GPT-5.5 muy por detrás de GLM-5.2 en alucinaciones, justo cuando la industria sigue asociando más escala con más valor.
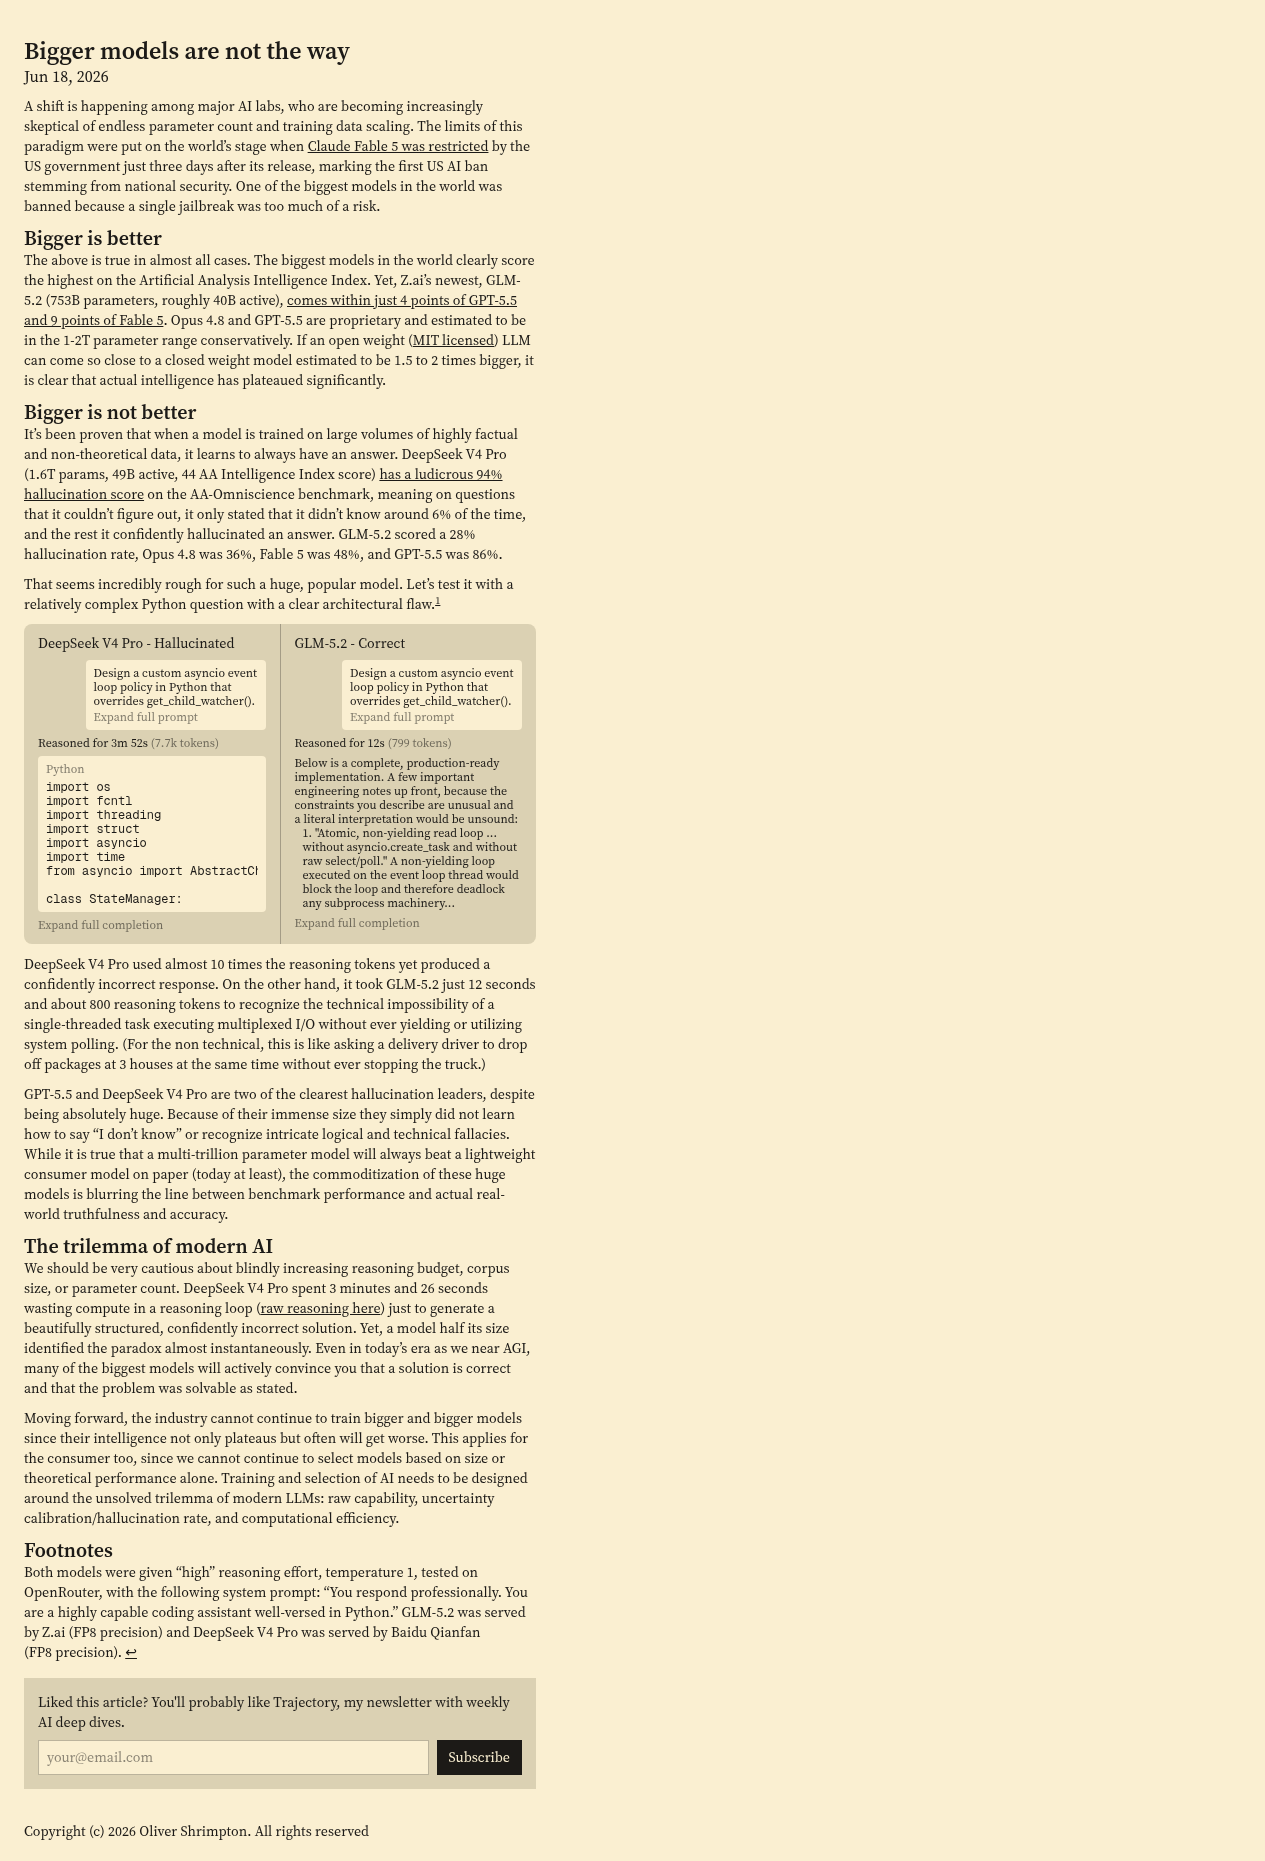
El debate sobre los modelos gigantes acaba de recibir un dato incómodo. Una comparativa publicada por ArrowTSX sitúa a GPT-5.5 muy por encima de GLM-5.2 en capacidad aparente, pero también mucho peor en comportamiento cuando el modelo tiene que admitir que no sabe algo. La diferencia no es de matiz: la cifra de alucinaciones pone en cuestión la idea de que seguir creciendo en parámetros, por sí solo, produce sistemas más útiles.
La sorpresa no es que un modelo sea mejor en benchmarks
Eso ya lo da por hecho casi cualquiera que siga el mercado. Lo relevante es que el modelo abierto GLM-5.2, con 753.000 millones de parámetros y unos 40.000 millones activos, se acerca mucho a modelos propietarios mucho más grandes en puntuación general, mientras reduce de forma notable el error confiado. La lectura práctica es bastante clara: el tamaño sigue importando, pero no explica todo lo que importa.
En el extremo opuesto, GPT-5.5 aparece como un modelo muy capaz y, al mismo tiempo, demasiado seguro de sí mismo en escenarios donde debería frenar. Ese patrón es más problemático que un fallo aislado, porque en una aplicación real no se ve como una respuesta mal dada, sino como una sucesión de decisiones plausibles que luego cuestan corregir.
Lo que de verdad mide una alucinación
La utilidad del dato está en que desplaza la conversación. Ya no basta con preguntar quién responde más rápido o quién resuelve más ejercicios de código. Cuando un modelo entra en flujos de trabajo largos, agentes, soporte o análisis, la pregunta útil es otra: ¿sabe parar a tiempo?, ¿reconoce el límite?, ¿puede decir “no sé” sin desmoronarse?
Ahí es donde este tipo de comparativas se vuelven incómodas para la industria. Un sistema que “parece” más inteligente, pero fabrica más respuestas falsas, puede ser peor producto aunque gane en demostraciones. Y eso vale tanto para un laboratorio que vende acceso premium como para un equipo que integra modelos en software interno.
La lección que deja este cruce entre GPT-5.5 y GLM-5.2 no es que el escalado haya muerto. Es más precisa y más molesta: el mercado ya no puede usar el tamaño como atajo mental para hablar de calidad. En 2026, fiabilidad y calibración pesan tanto como la capacidad bruta. Quizá más.
Artículos relacionados

Astra, el nuevo modelo de OpenAI, confirma una tendencia incómoda: la IA ya juega en defensa y ataque
La llegada de Astra no solo importa por su potencia: también deja claro que la próxima batalla de la IA pasa por la seguridad, la automatización y el control de sistemas reales.
Thinking Machines estrena su primer modelo de pesos abiertos y lanza un mensaje más grande que el producto
La startup de Mira Murati apuesta por control, adaptación y menos dependencia de un único proveedor.